邊緣智慧 · IHCI 2026 · 論文 106
Raspberry Pi 5 工程助手
讓資料來源與計算步驟清楚可見的課程助手。
電氣與電子工程
寧波諾丁漢大學
已獲 IHCI 2026 接納為口頭報告。提供 2026 年 9 月最終提交的作者版本論文。
在 GPU 基準環境中比較七種配置,依 0–1 的評分標準計算平均分數。
Base + Tools;96 題中有 54 題符合研究設定的完全正確標準。
此處只測試不查閱外部資料的 Base 配置,與 Base + Tools 不同,不能直接用來比較兩種硬體的表現。
項目概覽
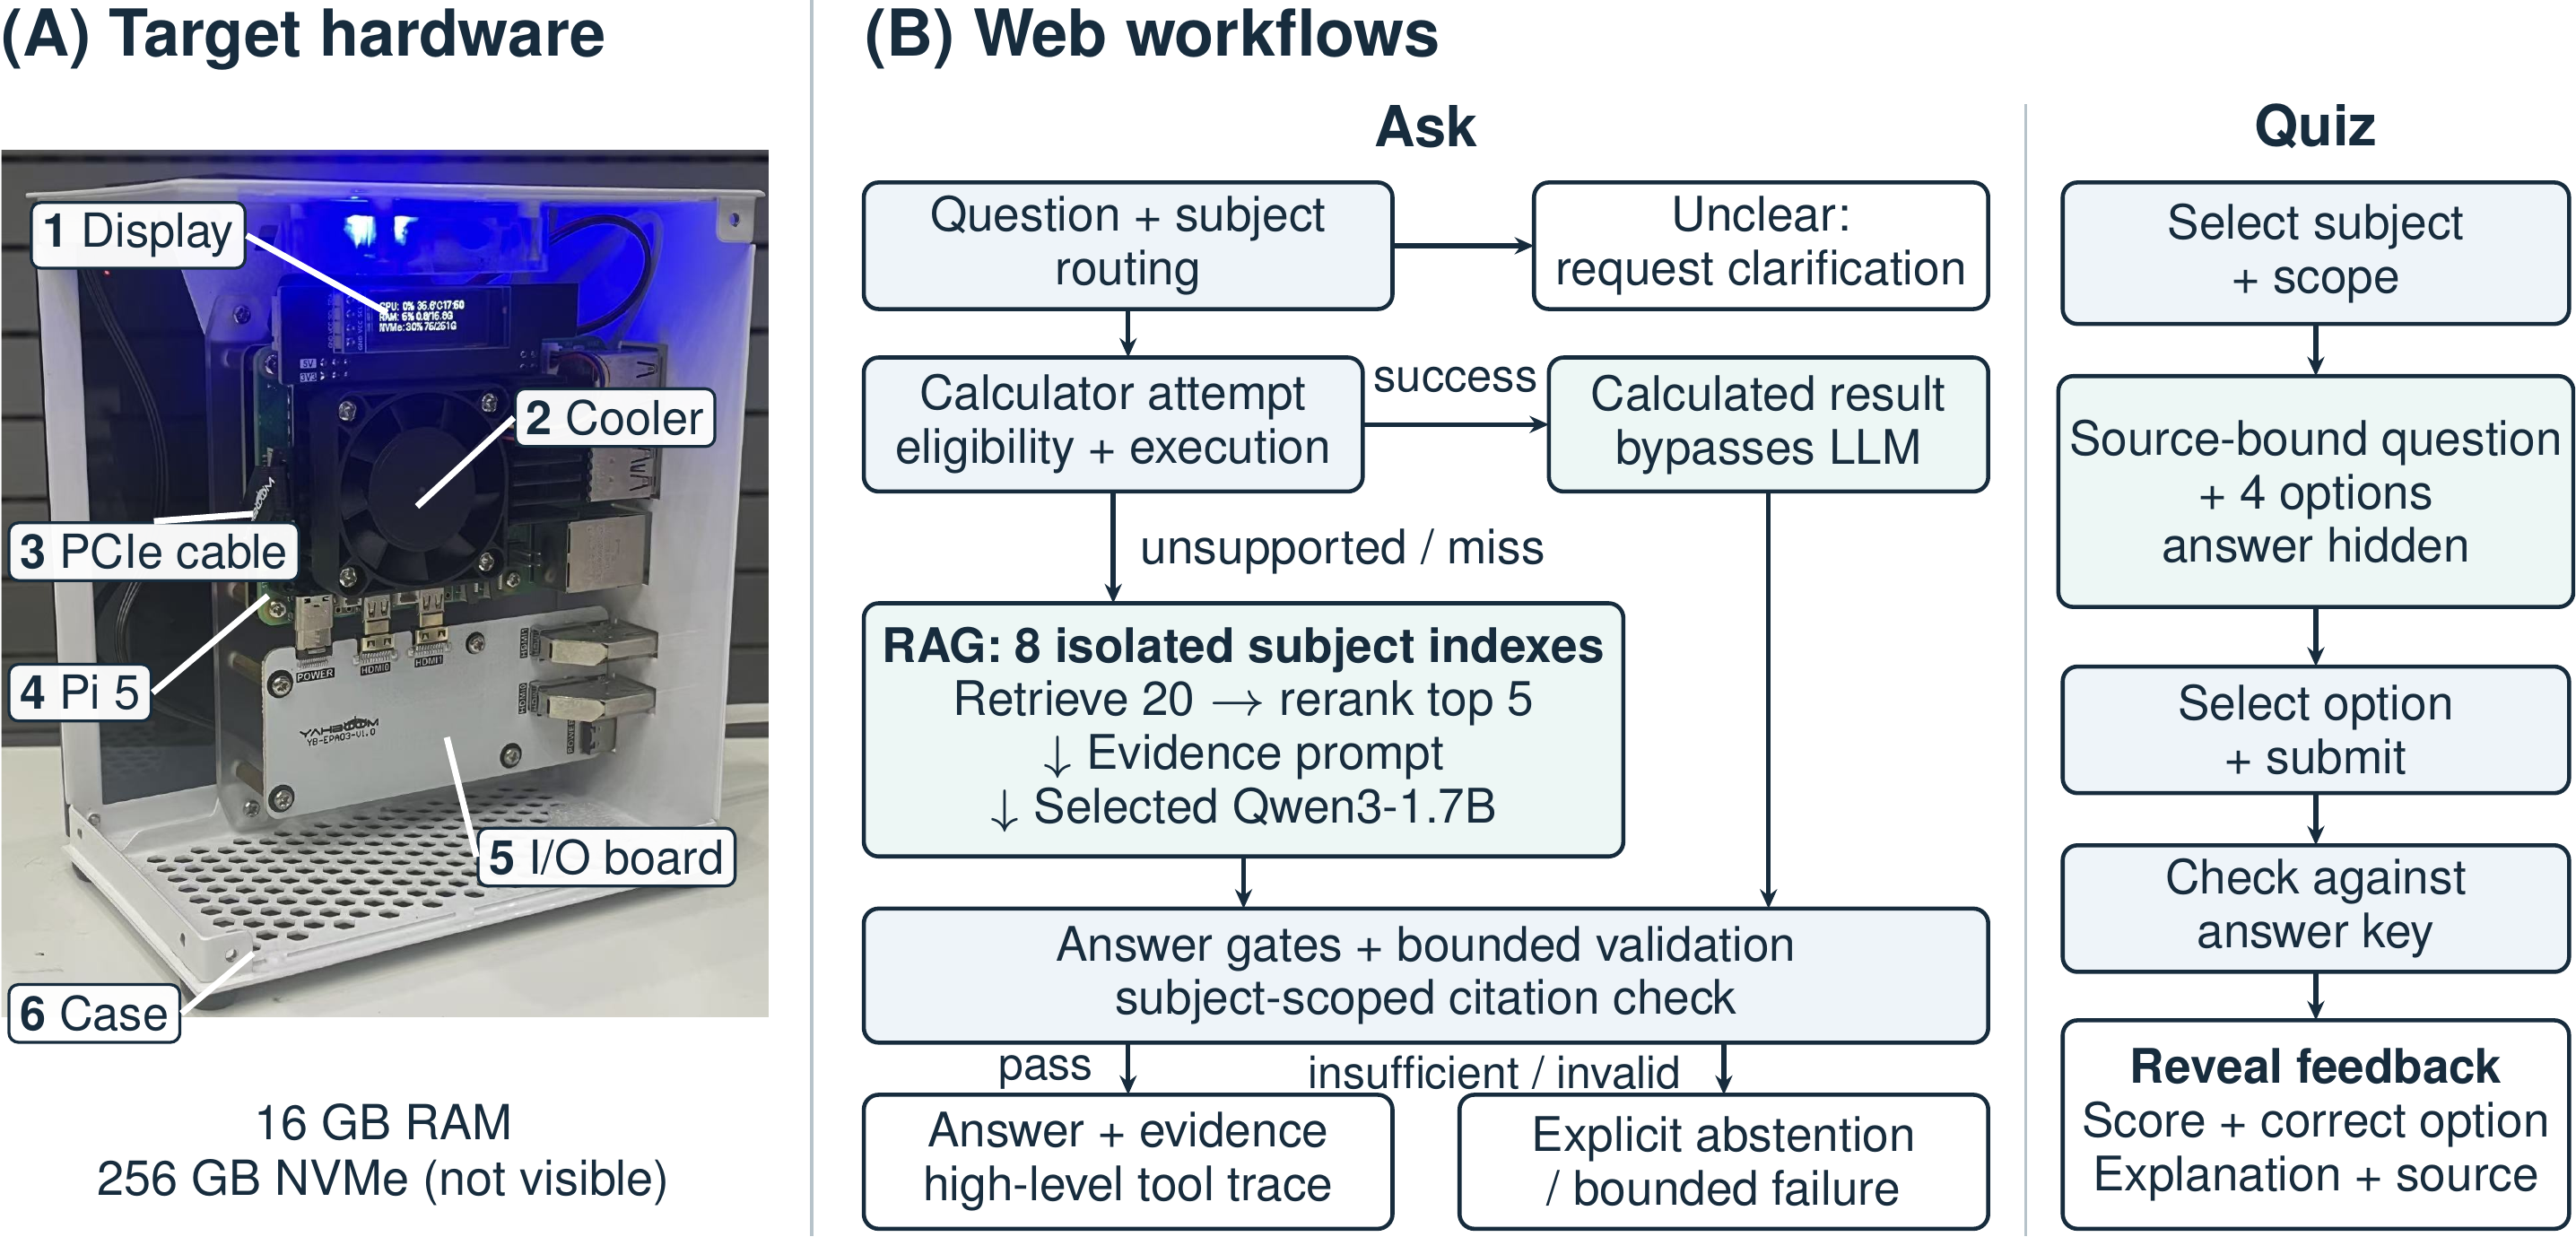
小型語言模型即使回答流暢,也可能用錯資料或算錯數字。我們的原型把四位元 Qwen3-1.7B 模型、課程資料檢索與確定性計算工具結合,讓答案有可查閱的依據。
Ask 在答案旁顯示資料來源或計算過程;Quiz 則在使用者作答後,提供回饋及相關資料。平台以 Raspberry Pi 5 為目標裝置,各項元件與不同裝置的評估結果分別列出。
評估結果與限制
主要測試在離線 GPU 環境中進行,以 96 道電氣與電子工程題目比較七種配置。下表列出依 0–1 評分標準計算的平均分數,以及達到完全正確標準的答案數。
| 配置 | 平均評分 | 完全正確 |
|---|---|---|
| Base(不查閱外部資料) | 0.503 | 28 / 96 |
| Base + RAG | 0.555 | 34 / 96 |
| Base + Tools | 0.777 | 54 / 96 |
| 初始 SFT(不查閱外部資料) | 0.438 | 25 / 96 |
| 初始 SFT + Tools | 0.750 | 52 / 96 |
| 擴展 SFT(不查閱外部資料) | 0.408 | 21 / 96 |
| 擴展 SFT + Tools | 0.584 | 39 / 96 |
RAG 是檢索增強生成,SFT 是監督式微調。這裡的評分不是準確率百分比。Base + Tools 在 RAG 中加入工具:支援的計算交由確定性 Calculator 執行,其他請求則使用檢索。上方特別列出的 GPU Base + Tools 與 Pi Base(不查閱外部資料)採用不同配置,不能視為相同條件下的硬體比較。
另一次配對比較在兩種裝置上都使用不查閱外部資料的 Base、相同的量化模型檔案及 96 道題目。GPU 平均分數為 0.503,Pi 為 0.498;平均差值(Pi − GPU)為 −0.005,95% 區間為 −0.041 至 +0.032。這些結果尚不能證明兩者的答案品質相同。
在另一組對檢索敏感的 24 道題目中,Base+RAG 得分 0.779,閉卷 Base 為 0.325(平均增加 +0.454)。完全正確結果的 Holm 校正檢定為 p = 0.0625,未達 0.05 門檻。在預先分類為計算器支援的 24 道題目中,Base+Tools 的平均分數比 Base+RAG 高 +1.000。兩種受測 SFT 方法均未超越對應的 Base 配置。
評分先由 AI 依評分標準協助進行,再由作者審閱,並未經過獨立盲測。裝置測試與個別網頁示範的結果分開呈現。研究尚未評估學習成效、易用性或整個網頁系統的可靠性;來源與計算過程有助於核對答案,但不能保證答案正確。
相關資料
- 論文PDF · 11 頁 · 1.9 MB (英文)
2026 年 9 月最終提交論文:保留十頁原文,前附版本及分享條款說明。
- IHCI 2026 簡報PDF · 13 頁 · 1.2 MB (英文)
2026 年 10 月 29 日修訂的 13 頁簡報。
- 已提交的 FoSE 研究展示海報PDF · 1 頁 · 0.4 MB (英文)
2026 年 10 月 20 日提交的海報;公開副本已移除學號。
此作者版本依照 Springer Nature 分享條款 提供,並非出版社正式出版版本。
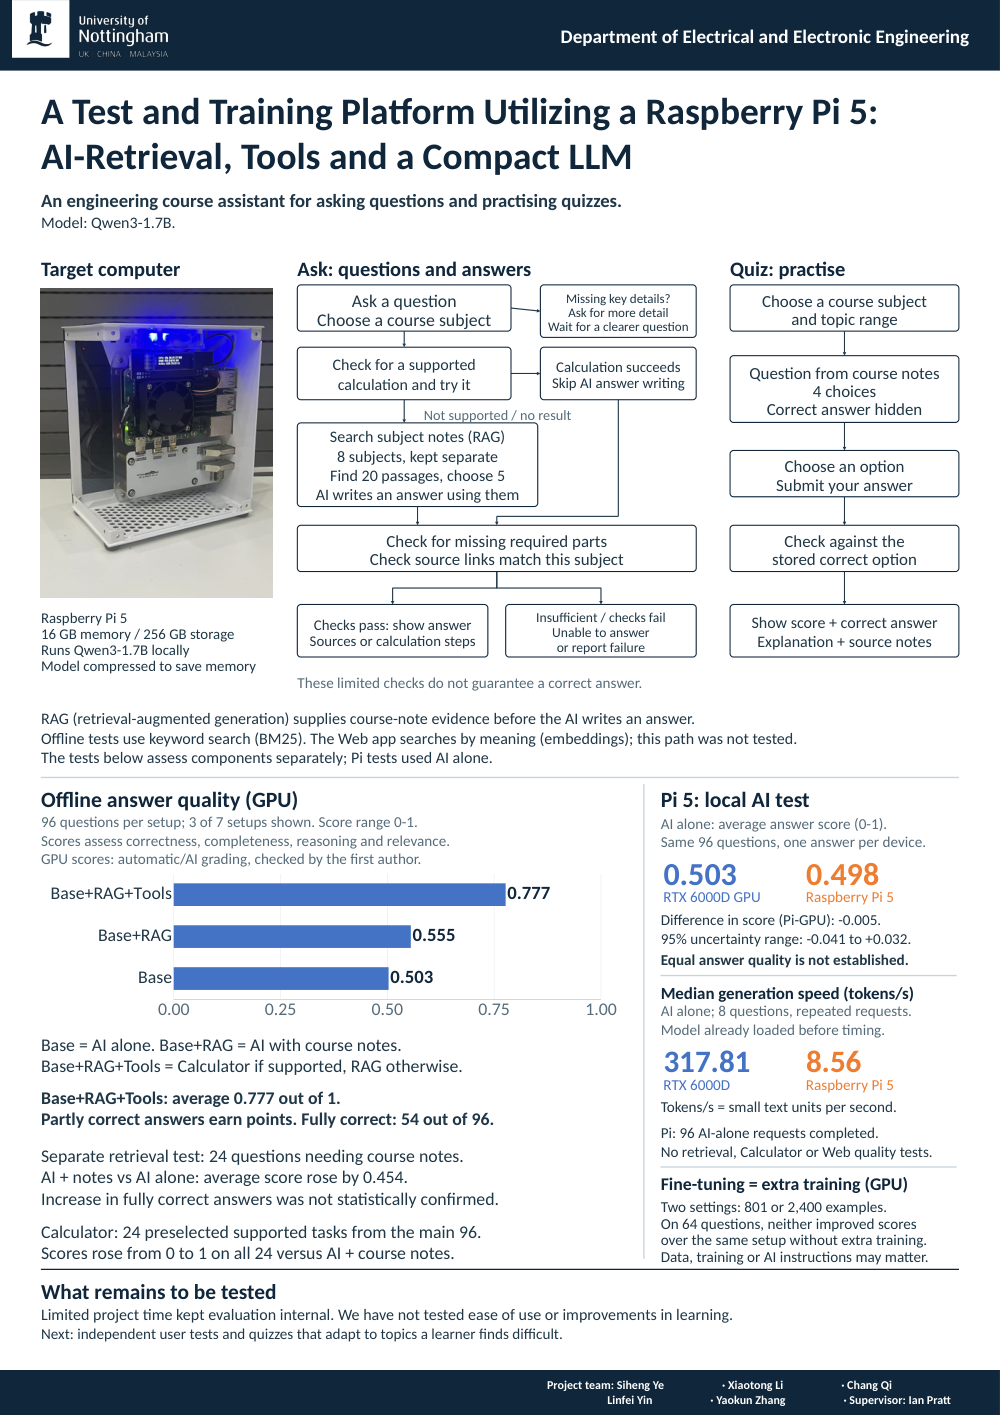 (英文)
開啟完整海報 (英文)
公開原始碼
公開儲存庫包含應用程式、檢索與計算原始碼、通用範例及設定說明,不包含私人課程資料、受限基準測試資料包、模型權重及部署設定。完整使用 Ask/Quiz 需要獲授權的語料、已建立的索引及相容的模型執行環境。
儲存庫與設定說明研究紀錄
A Lightweight Test and Training Platform Utilizing a Raspberry Pi 5: AI-retrieval, Tools and a Compact LLM
IHCI 2026 · 論文 106 · 已獲接納為口頭報告。
本頁與引用資料採用 IHCI 2026 證書及官方議程所載題名。9 月的作者定稿保留原題名「A Test and Training Platform Utilizing a Raspberry Pi 5: AI-Retrieval, Tools and a Compact LLM」。議程場次:2026 年 10 月 30 日 15:30–16:30 · SS2 · IEB 124 · 寧波(UTC+8)。論文集出版、DOI 與索引收錄仍未確認。
論文摘要
通用語言模型助手未必能自然契合特定課程。我們提出一個以 Raspberry Pi 5 為目標裝置的平台,結合小型 Qwen3-1.7B 模型、以課程資料為依據的檢索、確定性計算,以及呈現答案、證據和工具執行情況的網頁介面。平台可依個別課程需求設定;本研究評估系統品質與邊緣部署,而非學習成效。GPU 加速評估以 96 道課程題目比較七種配置,涵蓋閉卷生成、檢索增強生成(RAG)、Calculator 執行與兩種監督式微調(SFT)方法。另以 24 道題目比較 Base 與 Base+RAG。Base + Tool-Augmented RAG 在 0–1 評分規準中取得最高平均分數 0.777。檢索提升了對來源敏感題目的平均作答品質;確定性 Calculator 執行在預先分類為支援的 24 題中帶來最明顯的增益。兩種 SFT 方法均未顯示優於對應 Base 配置的改善。96 題配對 Base 比較未檢出具方向性的 GPU–Pi 分數差異;Pi 執行相同量化模型檔案時較慢。